01 人工主导
素材进入项目之前先整理什么
先核对文件完整性、拍摄日期、授权备注和场次信息,再决定是否进入辅助分析流程。
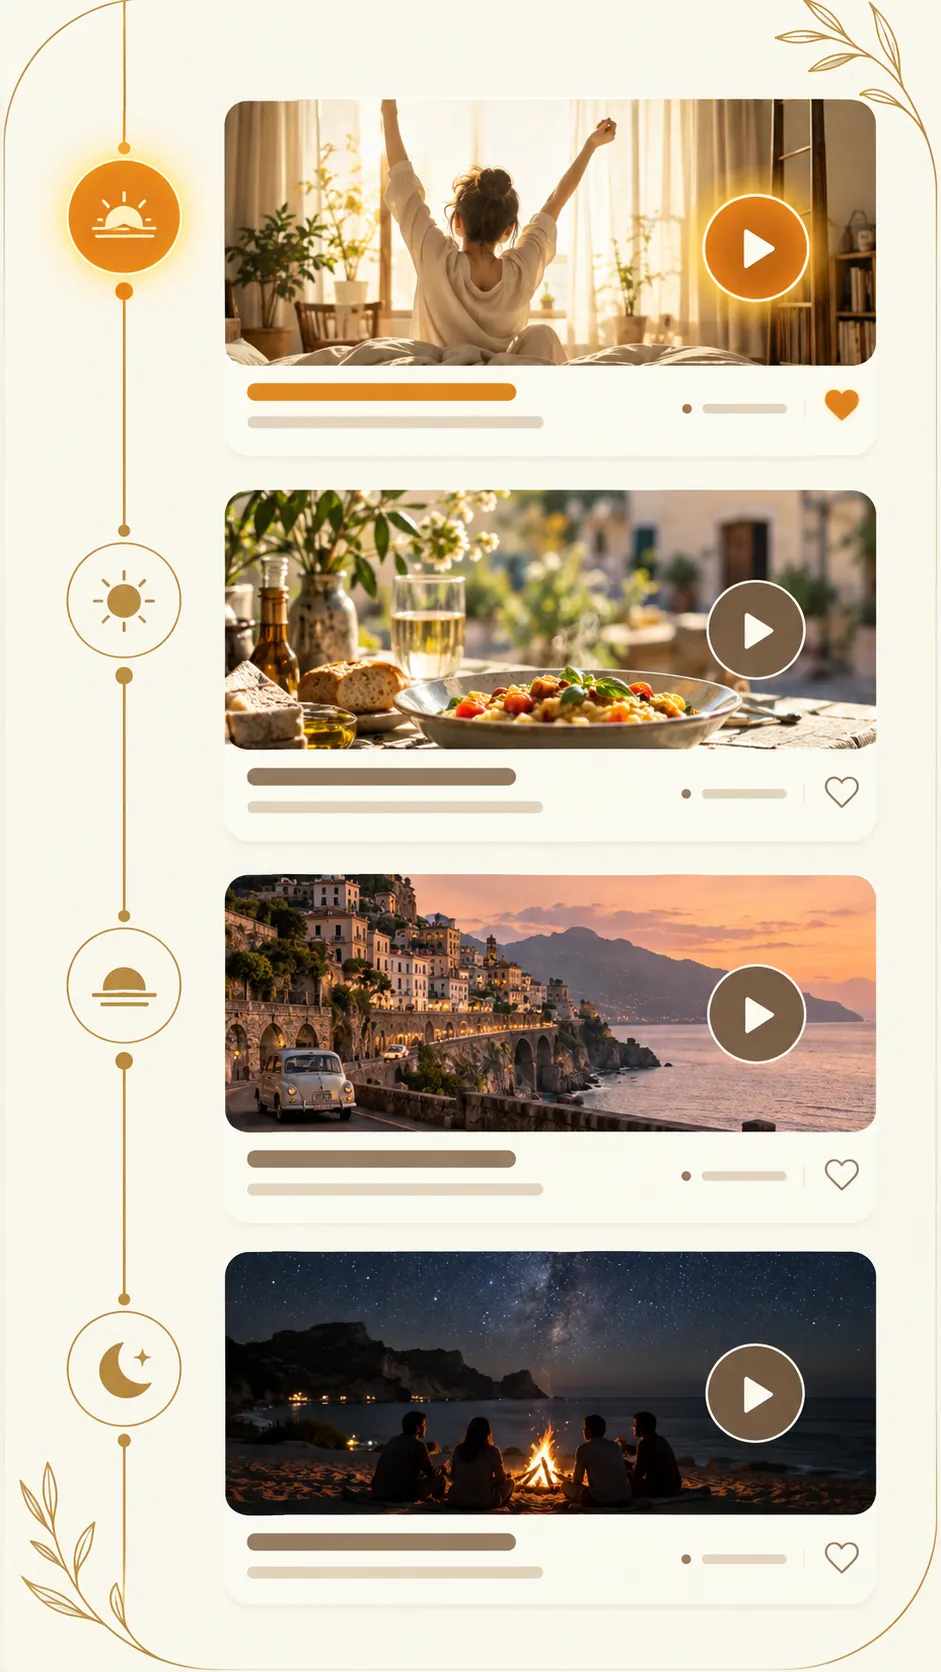
AI 视频剪辑可以帮助整理素材、提出粗剪建议、生成字幕初稿和提示节奏节点,但不能替代作者对事实、语境、授权、隐私与最终表达的责任。这里用时间线工作区展示每一步的人工检查点。
先核对文件完整性、拍摄日期、授权备注和场次信息,再决定是否进入辅助分析流程。
利用时间、画面变化和文件信息生成初步分组,再由编辑确认场景边界与叙事关系。
让系统提出可用镜头顺序,再检查是否漏掉必要信息、是否误解人物关系以及是否存在重复表达。
把人名、地名、数字和专业词列为高风险字段,逐条与原始声音或公开资料核对。
节奏建议可以提示停顿和动作节点,但必须先保证句意完整、反应镜头有上下文、人物表达不被歪曲。
不要只检查修改点;完整观看可以发现跨段落的称谓、时间、声音和视觉连续性问题。
根据发布渠道选择合理画幅与码率,同时保留清晰版本号、日期和审核状态,避免误传旧版。
重点检查门牌、票据、屏幕通知、车牌和非公开聊天等可能被忽略的个人信息。
把粗剪版本与人工修订版本并排,记录每次保留、删除或移动镜头的具体理由。
完成发布后整理工程、最终文件、来源备注和授权记录,为后续修改保留清晰上下文。
自动化最适合处理重复、可验证的中间工作,例如文件分组、时间标记、转写初稿与候选切点。涉及人物关系、事实判断、情绪语境和版权边界时,机器建议只能作为线索,最终要回到原始素材与公开信息。
素材进入工作流之前,先检查文件完整性、拍摄日期、场次、来源与授权备注。信息不清楚的文件单独标记,不用猜测补齐。
第一版只需要形成可审阅结构:覆盖必要信息、保留上下文、避免重复。不要把“机器给的顺序”当成已经完成的叙事。
根据文件时间、画面变化和转写内容生成候选顺序,适合快速建立目录。
重新检查人物关系、事件先后与动作完整性,删除机器无法判断的误连和重复。
自动转写能减少输入,但相近发音可能直接改变事实。人名、地名、时间、金额、型号和专业术语应被列成重点词表,与原始声音或可靠公开资料逐条核对,再处理断句和阅读节奏。
节奏建议可以指出停顿和动作节点,但不能为了“更快”删掉必要限定条件、反应镜头或上下文。
采访与教程中的限定词可能决定整句话的准确性,不能因为停顿较长就先删掉。
同一动作测试提前切、中间切与延后切,观察连续性和情绪变化。
用环境声和对白跨切减少硬边界,但不要让声音掩盖场景实际变化。
跨段落问题往往在局部看不出来。完整回看时同时检查称谓、时间线、字幕、声音、授权、隐私和画面边缘信息;遇到无法确认的内容,回到原始素材与公开来源,不用模型猜测填空。
完成剪辑不等于可以发布。画幅、码率、音轨、字幕、封面、文件名和版本状态都需要在最终文件里再次核对。
门牌、票据、屏幕通知、车牌、私人聊天和非公开位置可能只在几帧里出现。发布前应人工检查并依据实际用途选择裁切、遮挡或删除;无法确认是否适合公开时,优先减少暴露。
查看隐私说明对照的目的不是证明机器或人工谁更强,而是记录修改理由。
机器按停顿切分句子,专有名词也出现同音错误。问题主要是阅读语义与事实字段。
人工回听原始声音,调整断句并查证公开资料;修改记录保留在项目笔记中。
自动成片、字幕、隐私、版权与导出相关说明。
AI剪辑室展示的是辅助工作流,包括素材整理、镜头分组、粗剪建议、字幕辅助和节奏提示。它不会宣称自动结果可以替代作者判断。事实、语境、版权、隐私和最终叙事都需要人工复核,导出前还应完整观看并检查关键字段。
创作动态只整理公开信息、平台公告、作品消息和行业观察。遇到传闻型内容,会分别呈现原始说法、公开来源类别、后续变化、公开回应、当前核验状态与更新时间,并使用待核实、已回应、已澄清、信息不足或仅为公开讨论等标签。
不可以。社区不接受住址、手机号、证件号、车牌、精确定位、私人聊天、非公开行程、医疗隐私或其他可能导致人肉与骚扰的信息。讨论应围绕作品、公开活动与可验证资料展开;发现敏感信息时应停止扩散并通过联系页反馈。
当前版本的收藏、最近浏览和部分界面偏好使用浏览器 localStorage 在本机保存,代码会在存储不可用时自动降级,不影响正文浏览。隐私页会说明这些本地数据的用途和清理方式;本站不把本机状态描述成跨设备云同步。
因为作品展示必须尊重版权和授权范围。若没有明确、合法的下载来源,页面不会提供空链接、盗版地址或误导性按钮。我们更关注作品内容、作者背景、制作方法与相关学习路径,让用户知道在哪里继续了解,而不是制造虚假的“可下载”承诺。
先看教程目标和方法,不必先追求同型号设备。多数课程会说明场景、难度、时长和练习重点,并强调曝光、构图、收音、节奏等可迁移判断。涉及具体设备能力时,以你手头设备的官方说明为准,再根据实际画面和声音结果调整。